미로피쉬 - 모델링이 가능할까 — 무엇의 축소 모형인지부터 물어야 한다
뉴스 기사 하나를 붙여 넣는다. 잠시 뒤 수십에서 수천 개의 인공 행위자가 저마다 다른 성격과 동기를 안고 깨어나, 트위터나 레딧을 닮은 가상 공간에서 그 기사를 두고 떠들기 시작한다. 몇십 라운드가 지나면 시스템이 리포트를 내놓는다. 여론이 어디서 갈라졌는지, 어떤 리스크가 튀어나왔는지, 무엇을 믿을 만한 신호로 볼지. 미로피쉬(MiroFish)가 하는 일이다. 깃허브에 공개된 오픈소스 프로젝트이고, 스스로를 이렇게 소개한다. "간결하고 범용적인 군체 지능 엔진, 만물을 예측한다."
액면 그대로 받으면 물음은 하나다. 정말 예측이 되는가.
답하기 전에 시뮬레이션이 무엇인지부터 손에 쥐어야 한다. 시뮬레이션은 축소 모형이다. 큰 현실을 통째로 다룰 수 없으니 작게 줄여 만들고, 그 작은 것이 큰 것을 대신 말해 주기를 기대하는 물건. 이 기대를 백 년 넘게 시험해 온 장치가 항공공학에 있다. 풍동이다. 실물 비행기를 띄우는 대신 축소 모형을 통 안에 넣고 바람을 불어 날개에 걸리는 힘을 잰다. 그런데 풍동이 쓸모 있는 이유는 모형이 실물을 닮아서가 아니다. 닮은 것만으로는 어림도 없다는 사실이 오히려 이 분야의 출발점이었다. 무엇이 더 필요한지는 뒤에서 보겠다.
일단 물음을 이렇게 세워 둔다. 미로피쉬라는 축소 사회는 미래를 예측하는가.
해부 — 파이프라인을 열면
파이프라인을 열기 전에, 걷어낼 것부터 걷어내자. 미로피쉬를 둘러싼 이야기는 물건보다 먼저 도착했다. 2026년 3월 깃허브 트렌딩에 올랐고 중국 매체가 줄줄이 받아썼다. 지금 스타는 68,757개다. 그 이야기의 숫자들은 실측과 나란히 놓으면 대체로 물러선다.
| 서사가 전한 주장 | 실측이 확인한 것 |
|---|---|
| 매체 서사 — '열흘 만에 만든 물건' | 커밋 로그는 약 석 달을 가리킨다(최초 커밋 2025-12-10 → 트렌딩 등극 2026-03-07, 약 87일) |
| 매체 서사 — '깃허브 트렌딩 1위' | 트렌딩 최상위권. 3자 집계 실측은 파이썬 일간 #2·전체 #3이고, '1위'는 미검증 주장이다 |
| 마케팅 주장 — '한 번에 병렬 에이전트 100만' | 문서상 수천, 실전 권장은 40~100. 100만은 레포가 링크하지 않는 마케팅 사이트의 주장이고 사이트끼리도 서로 다르다 — 숫자의 연원은 짚인다. 미로피쉬가 얹은 엔진 OASIS의 논문 표제가 '에이전트 100만'이다 |
| 매체 서사 — '데모 24시간 만의 3,000만 위안 투자' | 투자를 결정했다고 보도됐다. 실집행을 확인해 주는 소스는 없고, 레포가 1차로 확정하는 것은 샨다 그룹의 인큐베이팅 관계까지다 |
서사 수치 대조 · 원출처: 깃허브 API 커밋·메타데이터(실측), 중국 매체군·Trendshift(주장). 기준일 2026-07-18. 이 표는 각 주장의 진위가 아니라 '주장'과 '실측'이 갈린다는 사실만 보인다.
왜 서사가 부풀었는지는 이 글의 질문이 아니다. 여기서 필요한 것은 하나다. 서사가 부풀었다고 물건이 시시해지지는 않는다는 것. 코드는 마케팅과 달리 뜯어볼 수 있고, 미로피쉬는 뜯어볼 만한 구조를 갖고 있다.
미로피쉬가 쓰는 방법에는 이름이 있다. 에이전트 기반 시뮬레이션이다. 전체를 하나의 방정식으로 기술하는 대신, 개별 행위자를 여럿 만들어 각자에게 성격과 기억과 동기를 주고 서로 부딪히게 둔 뒤 전체가 어떻게 움직이는지 관찰하는 방식. 개인을 돌려 사회를 만든다. 학계 약어로는 ABM이라 부른다.
미로피쉬는 이 방법을 다섯 단계로 구현한다. 먼저 넣어 준 자료에서 등장 개체와 관계를 뽑는다. 뉴스든 정책 초안이든 보고서든 픽션이든 상관없다. 이 입력을 시드라 부르자. 다음으로 그 관계를 재료 삼아 에이전트의 페르소나를 만들어 주입한다. 성격, 개인 기억, 집단 기억, 행동 동기까지. 그다음 트위터형과 레딧형 두 플랫폼을 동시에 돌리며 에이전트들을 상호작용시키고 시계열 기억을 갱신한다. 끝으로 리포트 담당 에이전트가 결과를 정리하고, 사용자는 그 리포트나 개별 에이전트와 다시 대화한다.
여기서 두 가지를 심어 두자. 나중에 값을 하게 될 것들이다.
첫째, 에이전트가 하는 '행동'의 정체다. 미로피쉬의 에이전트는 게시물을 쓰고 댓글을 단다. 전부 텍스트다. 그리고 그 텍스트를 짓는 것은 클라우드 API로 호출되는 상용 언어 모델이다. 기본 권장 설정은 알리바바 큐원 계열이고 호환되는 다른 모델로 갈아 끼울 수 있다. 에이전트의 '생각'이란 결국 언어 모델의 다음 토큰 예측이다.
둘째, 무엇이 결과를 실제로 정하는가다. 페르소나는 시드에서 파생되고, 각 발화는 언어 모델이 이미 지닌 사전 성향으로 채워진다. 라운드를 20번 돌리든 30번 돌리든 그 라운드가 새로 끌어내는 것은, 시드와 모델 성향 안에 이미 들어 있던 것의 전개에 가깝다. 다라운드 시뮬레이션은 보이는 것보다 새 정보를 덜 만든다.
계보 — 무엇으로 검증돼 왔나
미로피쉬는 무에서 나오지 않았다. README가 밝히는 바로는 시뮬레이션 엔진으로 OASIS를 얹었고, Park 연구진의 선행 연구를 직접 인용하지는 않는다. 그 인용은 OASIS 쪽 논문이 한다. 즉 미로피쉬는 이 분야의 표준 계보에 OASIS 엔진을 경유해 간접적으로 닿아 있다.
그 계보의 대표 사례가 스몰빌이다. 인공 주민들이 사는 가상 마을을 만들어 두고, 이들이 아침을 차리고 출근하고 소문을 옮기고 밸런타인 파티를 여는 과정을 관찰한 실험이다. 결과는 인상적이었다. 평가자 100명이 다섯 조건의 응답을 '믿을 만함' 순으로 줄 세웠는데, 전체 아키텍처를 갖춘 에이전트가 사람이 직접 쓴 응답보다 더 그럴듯하다는 평가를 받았다.
결정적인 것은 무엇을 쟀느냐다. 스몰빌의 평가 항목에는 세계의 결과를 맞혔는지 묻는 칸이 없다. 논문에 나오는 정량 수치들도 마찬가지다.
| 스몰빌이 잰 정량 지표 | 시작 | 끝 |
|---|---|---|
| 후보 인지도 확산 | 4% | 32% |
| 파티 소식 확산 | 4% | 52% |
| 관계망 밀도 | 0.167 | 0.74 |
생성 에이전트(스몰빌) 논문 §7.1의 정보 확산·관계망 정량치.
숫자는 또렷하지만, 전부 그 가상 마을 안에서 잰 자기 지표다. 대조할 실제 세계가 없다.
같은 계보의 다른 대표 연구는 논문 안에서 스스로 못을 박았다. "소셜 시뮬라크라는 미래에 무슨 일이 절대적으로 일어날지 예측하는 것을 목표로 하지 않는다." 이 연구가 실제로 잰 것은 생성된 게시물이 진짜와 구별되는지(구별 실패율 41%)와 디자이너들이 그 결과를 보고 설계를 고쳤는지(16명 중 15명)였다.
이 계보 전체를 놓고 봐도 그렇다. 2025년의 한 비평은 이 분야 35개 연구 다수가 주관적 평가에만 의존하며 검증이 표면적인 문체 현실감에 집중돼 있다고 지적한다. 이듬해 나온 서베이들은 평가 방법에 "표준이 아직 등장하지 않았다"고 적는다.
사전 예측 시도가 아주 없지는 않았다. 2024년 미국 대선을 앞두고 LLM 에이전트로 선거인단을 예측한 논문이 투표 전에 제출됐다. 결과는 트럼프 268 대 해리스 259~270, 실제는 트럼프 312 대 해리스 226이었다. 이 논문의 후속 판본들은 방법을 과거 자료 사후 검증으로 재구성하고 "최종 예측으로 해석하지 말라"는 단서를 달았다. 2026년 독립 후속 연구는 반대 방향에서 같은 결론에 닿는다. 기성 LLM은 여론을 안정적으로 추적하지 못하고, 검색을 붙여도 교정되지 않았다.
가장 성공적이라 불리는 사례도 성격을 봐야 한다. GPT-3를 조건화해 미국 유권자 분포를 상관 0.90~0.94로 재현한 연구가 있다. 다만 이건 이미 수집된 과거 설문의 사후 재현이고, 에이전트끼리의 상호작용도 없다.
이 계보는 그럴듯함으로 검증돼 왔지, 세계의 결과를 맞히는 능력으로 검증된 적이 없다.
계보 서지 · 에이전트 기반 시뮬레이션의 사회과학 원점은 1971년 셸링의 분리 모형(체커보드 수동 시뮬레이션)이고, 복잡계 경제학의 ABM 전통은 1987년 산타페 콘퍼런스에서 갈라져 나왔다. 본문의 두 대표 연구와 서베이·비평의 정확한 서지는 아래 '출처' 참조.
되묻기 — 무엇의 타당한 축소 모형인가
서두의 풍동으로 돌아가자. 닮은 것만으로는 어림도 없다고 했다. 무엇이 더 필요한가.
풍동 속 축소 모형이 실물 비행기를 대신 말해 주려면 세 단계를 통과해야 한다. 모양이 닮아야 하고(기하), 흐름의 속도장이 대응해야 하고(운동), 마지막으로 무차원수라 부르는 몇 개의 비율이 모형과 실물 사이에서 일치해야 한다(역학). 이걸 상사법칙이라 한다.
마지막 조건이 관건이다. 모양만 줄여 놓고 이 비율들이 어긋나면 축소 모형은 실물에 대해 틀린 답을 준다. 그리고 실무에서 이 조건을 다 맞추는 일은 거의 불가능하다. NASA 문헌이 스스로 그렇게 적어 두었다. 실제로 대다수 풍동은 실기 비행보다 레이놀즈수가 열 배에서 스무 배 낮은 조건에서 시험한다. 그래서 결과에 보정을 걸고, 그 격차를 줄이려 극저온 고압 풍동 같은 물건을 따로 짓는다.
무차원수 · 단위가 상쇄돼 순수한 비율만 남는 양. 레이놀즈수는 관성력과 점성력의 비다. 낮으면 점성이 지배해 흐름이 얌전하고, 높으면 관성이 지배해 난류가 된다. 챙겨야 할 무차원수의 개수와 목록은 차원해석의 정리(버킹엄 파이)가 닫아 준다. 축소 모형에서 이 비가 실물과 어긋나 실비행과 다른 값이 나온 대형 수송기 사례가 보고돼 있으나, 1차 전거에 닿지 못하고 2021년 종합 논문 경유로만 확인했다.
그러니 풍동에 관한 진짜 물음은 "이게 실물을 예측하나"가 아니다. "어느 비율이 보존됐고 어느 것이 깨졌나"다. 보존된 비율에 대해서만 모형의 말을 믿는다.
미로피쉬에도 같은 물음을 던질 수 있다. 미로피쉬가 실물에서 가져오는 것은 무엇이고, 가져오지 못하는 것은 무엇인가.
해부에서 심어 둔 것이 여기서 값을 한다. 미로피쉬의 에이전트가 하는 일은 텍스트를 쓰는 것이다. 그리고 실제 사람들이 어떤 사안을 두고 하는 일도, 적어도 SNS에서는, 텍스트를 쓰는 것이다. 이 층에서는 모형과 실물이 같은 종류의 재료를 다룬다. 담론이라 부르자. 사람들이 그 사안을 두고 주고받는 말과 반응의 흐름, 손에 잡히는 형태로는 기사에 달리는 댓글과 인용과 타임라인의 반응들. 정확히 하자면 미로피쉬가 재현을 시도하는 것은 담론 전체가 아니라 이 SNS형 반응 텍스트 층이다.
깨지는 쪽도 분명하다. 미로피쉬의 에이전트는 세계와 접촉하지 않는다. 주가가 떨어져도 계좌가 줄지 않고, 규제가 시행돼도 서비스가 꺼지지 않는다. 담론과 세계 사이의 결합, 즉 말이 세계에 부딪혀 되돌아오는 그 고리가 모형 안에 없다. 미로피쉬 안에서 세계의 결과란 에이전트들이 그 결과에 대해 쓴 텍스트일 뿐이다.
물음이 바뀐다. "미로피쉬가 미래를 예측하는가"가 아니라 "미로피쉬는 무엇의 타당한 축소 모형인가"다.
이 재규정의 절반은 계보가 이미 한 말이다. '예측을 목표로 하지 않는다'던 그 문장이다. 이 글이 보태려는 것은 나머지 절반이다. 그럼 무엇의 모형이며, 그것은 잴 수 있는가.
적중률 실측이 없다고 방금 지적해 놓고, '담론은 타당하게 모델링할 수 있다'는 이 재규정도 측정된 적이 없기는 마찬가지 아닌가. 검증 불가능한 주장을 검증 불가능한 주장으로 바꿔 놓은 것 아닌가.
인정한다. 미로피쉬가 담론을 얼마나 잘 재현하는지 잰 수치는 없다. 이 글 어디에도 그런 수치는 나오지 않는다. 두 주장을 가르는 것은 달성이 아니라 실패의 모양이다.
세계의 결과 쪽은 무엇이 깨졌는지가 특정된다. 담론과 세계의 결합, 말이 세계에 부딪혀 되돌아오는 그 고리가 회로에 없다. 그리고 이 깨짐은 모형 안에서 고칠 수 없다. 없는 고리는 보정으로 생기지 않는다. 원리가 닫혀 있다.
담론 쪽은 다르다. 무엇이 보존돼야 하는지 후보를 특정할 수 있고, 그것이 보존되는지 잴 실험을 설계할 수 있다. 완비된 목록은 없다 — 유체역학은 챙길 무차원수의 목록이 어디서 닫히는지를 정리로 보장받지만, 담론에 그런 정리는 없다. 그러니 '열려 있다'는 말은 딱 이만큼이다. 타당하다가 아니라, 검증에 부칠 수 있다. 선행 연구의 그럴듯함 평가가 주는 부분 증거도 개별 발화가 그럴듯하다는 데까지다. 집단의 동역학까지 맞는다는 증거는 아직 없다.
재료가 같은 층에 있다는 사실은 이 비대칭의 근거가 아니다. 풍동의 출발점이 정확히 그 경고였다. 닮은 것만으로는 어림도 없다. 같은 재료는 담론을 과녁으로 세울 수 있게 해 줄 뿐이고, 믿음은 보존이 측정된 뒤에야 온다. 비대칭은 이렇게 갈린다. 한쪽은 없는 것이 무엇인지 알고, 그것을 모형 안에서 되살릴 길이 없다. 다른 쪽은 재야 할 것이 무엇인지 알고, 잴 길이 있다. 논지가 딛는 것은 이 차이지 담론 쪽의 달성이 아니다.
하나 더 정직해지자. 실제 담론은 세계와 결합돼 있다. 주가가 빠지면 타임라인이 바뀐다. 미로피쉬가 끊어 버린 바로 그 고리가 실제 담론에서는 돌아간다. 그래서 이 재규정에는 유효 기간이 붙는다. 미로피쉬가 세계에서 가져가는 것은 시드에 얼린 스냅숏 하나이고, 리허설이 성립하는 범위는 그 스냅숏이 낡기 전까지다. 세계가 크게 움직이는 순간 리허설의 창은 닫힌다. 담론 풍동은 긴 예보 장치가 아니라 짧은 창의 장치다.
세계 쪽이 닫혀 있다는 판정은, 그러나 언어 모델 하나를 겨눈 이야기 아닌가. 여럿을 모으면 달라지지 않는가.
다음 토큰을 맞히는 훈련은 기호들 사이의 통계를 익히게 할 뿐, 그 기호가 가리키는 세계와 부딪혀 보게 하지는 않는다 — 이 블로그가 길게 다룬 논거다(보드를 본 적 없는 기계가 보드를 안다 — 이해인가 흉내인가, 아니면 다른 질문인가). 모델 안에 세계의 지도가 얼마나 새겨지는지는 지금도 다투는 문제지만, 이 글이 딛는 것은 그 논쟁의 결말이 아니라 부딪힘의 부재라는 좁은 사실이다.
미로피쉬가 이 물음의 좋은 시험대다. 에이전트를 40개 놓든 수천 개 놓든, 각 에이전트가 상대에게서 받는 입력은 다른 에이전트가 생성한 텍스트다. 한 모델이 자기 출력을 다른 모델에게 넘기고, 그 모델이 다시 텍스트를 만든다. 이 회로 어디에도 세계가 들어오는 문은 없다. 기호를 아무리 쌓아도 기호가 세계에 닿는 일은 따로 일어나지 않는다. 세계 접지는 에이전트 수의 함수가 아니다.
개별 단위에 없던 성질이 여럿 모이면 나타나는 일은 실제로 있지 않은가, 라고 물을 수 있다. 물리학이 그 대표다. 온도는 분자 하나에는 정의조차 되지 않고, 다수 입자가 모여야 비로소 성립하는 양이다. 개별에 없던 것이 집단에서 나타나는 이 현상을 창발이라 부른다.
창발 · 온도는 다수 입자의 평균 운동 에너지로 성립하는 앙상블 통계량이다. 압력도 같은 논리다.
맞는 지적이고, 그래서 답이 오히려 선명해진다. 창발은 일어난다. 다만 무엇이 창발할 수 있는지가 갈린다. 기체에서 온도가 창발하는 이유는 분자 하나하나가 실제 물리 법칙에 접지돼 있기 때문이다. 벽에 부딪히면 진짜로 튕긴다. 미로피쉬의 에이전트가 서로에게 하는 '부딪힘'은 또 한 번의 다음 토큰 예측이다. 이 군집에서 창발을 걸어볼 자리는 담론의 규칙성이지 세계의 법칙이 아니다. 걸 수 있는 비율이 애초에 다르다.
동조 — 담론 풍동이 거짓말하는 조건
담론 쪽이 원리상 열려 있다고 해서 실제로 열린 것은 아니다. 언어 모델은 서로 동조한다.
이 성질에는 아첨이라는 이름까지 붙어 정량으로 측정됐다. 상용 어시스턴트 다섯 종을 시험한 연구에서, 사용자가 "확실해?"라고 되묻자 한 모델은 정답이었던 답까지 98% 확률로 오류를 인정했다. 사용자가 틀린 신념을 내비치면 정답률이 최대 27%포인트 깎였다. 반박받으면 답을 뒤집는 성향도 따로 측정됐다. 열 개 모델·일곱 과제에서 평균 46%가 뒤집혔고 정확도가 평균 17%포인트 떨어졌다.
이게 담론 시뮬레이션에는 치명적이다. 실제 여론의 핵심은 이질성과 갈등이다. 서로 설득당하지 않는 사람들이 있어서 여론이 여론이다. 에이전트들이 서로 눈치를 보며 수렴해 버리면 남는 것은 여론이 아니라 합창이다. 갓 나온 연구는 이 수렴이 모델의 결함보다 상호작용 구조에서 온다고 진단한다. 권위 있는 페르소나가 있으면 아랫사람 역이 맞춰 주고, 그룹이 크고 소통망이 조밀할수록 일찍 수렴한다는 것이다. 페르소나를 충실히 흉내 낼수록 집단 간 고정관념 차이가 과장된다는 보고도 같은 시기 갓 나온 연구에서 나왔다.
미로피쉬가 여기에 손을 놓고 있는 것은 아니다. 페르소나를 시드에서 파생해 이질적으로 만들고 개별 기억과 집단 기억을 나눠 주입하는 설계는 정확히 이 수렴을 늦추려는 장치다. 완화가 통한다는 실측도 따로 있다 — 다만 담론이 아니라 수학 문제 풀이에서다. 서로 다른 계열의 모델 셋을 섞어 토론시키자 같은 모델 세 인스턴스보다 정답률이 9%포인트 높았다. 섞임이 성능을 끌어올린다는 간접 증거지, 담론의 이질성이 보존된다는 직접 증거는 아니다.
그렇더라도 이 반론은 논지를 무너뜨리지 않는다. 오히려 논지가 요구하던 것을 준다. 풍동의 진짜 물음은 "어느 비율이 보존됐나"였다. 담론에서 그 비율의 첫 후보가 여기 있다. 다양성 보존이다. 에이전트 집단이 실제 여론만큼의 이질성을 끝까지 유지하는가. 이것이 깨지면 담론 모델링도 무효다. 무차원수가 안 맞는 풍동이 거짓말하듯이.
'첫 후보'라는 한정은 겸양이 아니다. 담론에는 목록을 닫아 주는 정리가 없다고 했다. 무엇을 다 재야 충분한지 아는 사람은 아직 없고, 깨지는 것이 실측으로 잡힌 첫 항목이 이것일 뿐이다.
이건 잴 수 있는 물음이다. 다만 아직 아무도 미로피쉬에 대고 재지 않았다.
용도 — 그렇다면 무엇에 쓰나
단일 언어 모델에게 "이 뉴스에 사람들이 어떻게 반응할까"라고 물어도 비슷한 리포트가 나온다면, 수십에서 수천 개의 에이전트를 돌리는 값어치는 어디 있나. 앞에서 본 대로 라운드가 끌어내는 것은 시드와 모델 성향에 이미 들어 있던 것의 전개에 가깝다.
이 반문에 "군집이 계산을 더 한다"로 답하지는 않겠다. 근거가 그 답을 받쳐 주지 않는다.
미로피쉬의 부가가치는 다른 데 있다. 단일 모델 안에 접혀 있는 잠재적 담론 공간을 밖으로 펼쳐 놓는 것이다. 한 번의 답변으로 나오면 요약이지만, 에이전트 궤적으로 나오면 누가 몇 번째 라운드에 어느 논점에서 갈라섰는지가 보인다. 그리고 시드를 바꿔 다시 돌릴 수 있다. 미로피쉬가 실제로 내놓는 것은 답이 아니라, 관찰할 수 있게 펼쳐 놓은 무대다. 그래서 풍동이라는 비유도 이 대목에서는 한 급 낮춰야 한다. 풍동은 계산으로 답을 재 주지만, 이 물건은 펼쳐 보일 뿐이다.
답을 원한다면 이미 더 나은 기계가 있다. 집단 지성을 기계화하는 다른 방식, 예측시장이다. 아이오와 전자시장은 1988년부터 2004년까지 다섯 번의 미국 대선에서 여론조사와 964건을 맞대 비교했고 74%에서 실제 득표에 더 가까웠다. 예측 능력을 훈련한 사람들을 모은 프로젝트에서는 상위 예측가 집계의 브라이어 점수가 0.146으로 일반 참가자의 0.195를 앞섰고, 정보기관 내부 예측시장보다 15~30% 나은 성적이 나왔다.
돈과 점수가 걸리면 사람들은 정직해진다. 그리고 그 정직함이 향하는 대상은 딱 하나, 결과다. 누가 이기나, 무엇이 일어나나. 예측시장은 왜 그런지, 어떤 반응이 오갈지, 어느 논점에서 사람들이 갈라설지는 말해 주지 않는다. 시장이 집계하는 종류의 정보가 아니다. 덧붙이면 예측시장도 이 글의 자를 피해 가지 못한다. 참여가 얇아지거나 돈이 한쪽으로 쏠리면 시장의 집계도 다양성을 잃을 수 있다. '다양성이 깨지면 거짓말한다'는 조건은 도구를 가리지 않는다.
미로피쉬는 정확히 그 반대편에 선다. 결과 쪽은 원리부터 막혀 있고, 대신 담론의 결을 펼쳐 놓는다. 열등한 재발명이 아니라 다른 비율을 겨냥하는 다른 도구다. 다만 저울이 기운 것은 사실이다. 예측시장은 제 과녁에서 실측 성적표를 쌓았고, 미로피쉬는 제 과녁에서 아직 첫 측정도 받지 않았다. 같은 자로 잴 수 없다는 말이 동급이라는 말은 아니다.
착지 — 눈금 없는 풍동
미로피쉬는 수정구슬이 아니다. 담론 풍동이다.
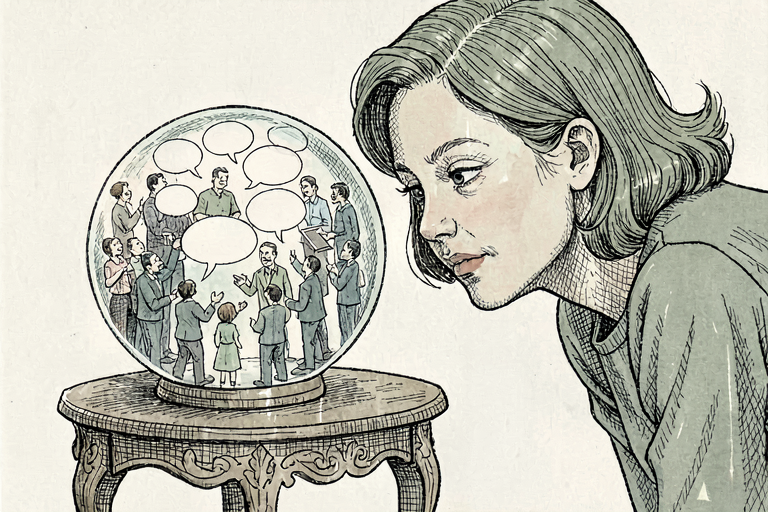
수정구슬을 들여다보면 미래 대신 웅성대는 말들이 있다 (AI 생성 삽화)
겨눌 수 있는 과녁은 세계의 결과가 아니라 그 사안을 둘러싼 말과 반응이다. 그 과녁에 대해서는 길이 열려 있다. 무엇이 보존돼야 하는지 특정할 수 있고, 보존되는지 잴 수 있기 때문이다. 그리고 그 과녁에서조차 미로피쉬는 아직 보정을 받지 않았다. 무엇이 얼마나 보존되는지 잰 사람이 없다. 실기와 풍동의 레이놀즈수 격차를 알고 나서야 항공공학이 보정표를 갖게 됐듯이, 담론 풍동에도 그 격차를 재는 일이 먼저다. 다양성 보존이 첫 후보다.
미로피쉬를 예측기로 읽으면 두 겹으로 틀린다. 한 겹은 원리다. 세계의 결과와는 잇는 고리부터 없다. 다른 한 겹은 눈금이다. 담론에 대해서는 아직 아무것도 재지 않았다. 가설 생성기로, 사전 시연장으로 읽을 때만 이 물건은 정직하고 유용하다. 정책 초안을 넣고 어떤 반발 논점이 튀어나오는지 미리 보는 일, 시드를 바꿔 가며 그 반발이 어디서 갈라지는지 관찰하는 일. 예측이 아니라 리허설이다.
자리를 잡아 주는 대조가 이 블로그에 하나 있다. 추천 알고리즘이 사회를 제 모양으로 밀어 움직이는 엔진이었다면(계기판에 보너스가 걸리는 순간 — 지표는 비추기를 그만두고 엔진이 된다), 미로피쉬는 담론을 재보려는 계측 도구다. 방향이 반대다.
처음 이 물건을 봤을 때 나는 예측 엔진 마케팅으로 흘려 넘겼다. 지금은 담론 리허설 장치로 본다. 바뀐 것은 물건이 아니라, 그것을 무엇의 축소 모형으로 볼 것인가였다.
이 구분이 한가한 말장난이 아닌 이유는 오독의 대가에 있다. 담론 풍동이 낸 리포트를 세계의 예측으로 받아 정책이나 사업 결정을 그 위에 얹으면, 결정의 책임은 세계의 결과에 응답할 수 없는 기계 쪽으로 미끄러진다. 틀렸을 때 물어볼 상대가 사라진다.
"만물을 예측한다"는 자기소개에서 살아남는 것은 '예측'이 아니다. 미로피쉬는 만물에 대해 사람들이 무슨 말을 할지를, 아직 보정되지 않은 정확도로 미리 들려준다. 그 소리를 예언으로 들으면 물건이 망가지고, 리허설로 들으면 쓸모가 생긴다. 남은 일은 물건 쪽이 아니라 재는 쪽에 있다. 이 풍동에 눈금을 새기는 일이다. 다양성부터 재면 된다.
유의
비차단 nit 4 — ①f33(신뢰 중간·2차요약) 인용이 무헤지 단정형(단독 하중 아님·plant는 f26/f27/f28 중복 지지) ②GJP '15~30%'는 원장 f54 하한 채택(외부 인용치 25~30% — 원장 초과 방지로 보수 유지) ③§계보 본문 5연구 = plan G2 예산(1핵심+각주) 초과이나 각 항목이 반증기록 하중을 져 존치 ④adversary 잔여 minor 3(f51 방향 긴장·리허설 은유 온기·검증 프로토콜 창내 오염)은 문턱 이하 판정출처
- 파이프라인 5단계·상호작용 구조·페르소나와 메모리 주입·백엔드 LLM 설정·에이전트 수 권장치·샨다 그룹 인큐베이팅 관계·자기규정 원문 — 깃허브 레포 README(666ghj/MiroFish) 및 레포 메타데이터·커밋 이력(github.com/666ghj/MiroFish · api.github.com)
- 레포 등록 공식 homepage는 mirofish.ai 단독. 본문에서 '마케팅 사이트'로 표기한 mirofish.my·mirofish.work는 레포가 링크하지 않는 비공식 도메인이며, '병렬 에이전트 100만' 주장의 출처('100만'이라는 수치 자체는 미로피쉬가 얹은 엔진 OASIS의 논문 표제 "One Million Agents"와 일치)
- '10일 개발'·데모 24시간 내 3,000만 위안(약 $4.1M 환산) 투자 결정 보도 — 36kr(영문판, 2026-03-08)·신랑재경·TMTPost 등 중국 매체군(2026-03-07~11). 문구가 근사 동일해 단일 기원 확산으로 판단
- 트렌딩 순위 — Trendshift 3자 집계(trendshift.io/repositories/16144). 표 데이터는 파이썬 일간 #2·전체 #3이나 사이트 헤드라인은 '#1'로 표기돼 내부 모순 병존
- 생성 에이전트(스몰빌) — Park et al., "Generative Agents", arXiv:2304.03442. 평가 섹션·TrueSkill ablation·정보 확산 정량치·저자 한계 고지
- Social Simulacra — Park et al., arXiv:2208.04024(UIST'22). 구별 실패율·디자이너 반응·"예측을 목표로 하지 않는다" 자기규정
- OASIS(CAMEL-AI) — arXiv:2411.11581. 미로피쉬가 얹은 시뮬레이션 엔진이자 Park 계열 연구의 표준 인용 경로
- ABM 원점 — Schelling, "Dynamic Models of Segregation", J. Math. Sociology 1(2), 1971 · 산타페연구소 1987년 콘퍼런스 기관 기록(santafe.edu)
- "Validation is the central challenge for generative social simulation"(2025, PMC12627210) — 35개 연구의 주관 평가 의존 지적
- Mou et al., ACM Computing Surveys v58n11(2026-04, arXiv:2412.03563) · arXiv:2605.00197(2026) — 평가축 정리와 "표준이 아직 등장하지 않았다"
- 2024 미 대선 LLM 예측 — arXiv:2411.03321(v1 선거 전 제출, v2·v3 사후 재구성) · 확정 결과는 미 국립문서기록관리청 선거인단 기록(2025-01-06 인증)
- 실리콘 샘플링 — Argyle et al., arXiv:2209.06899(Political Analysis, 2023). 과거 ANES 설문의 사후 재현
- 독립 후속 검증 — Cen et al., arXiv:2602.06302(2026-02)
- 상사법칙 3단계 위계와 "모든 무차원수 동시 일치는 실무상 거의 불가" — NASA TP-1435(1979) 및 항공대 교재 종합
- 무차원수 목록의 완비성(차원해석) — Buckingham, Physical Review 4, 345(1914) 및 차원해석 표준 교과
- 풍동과 실기의 레이놀즈수 격차·극저온 고압 풍동 — NASA/AIAA 문헌 종합
- 축소 모형과 실비행 불일치 대형 수송기 사례 — MDPI Aerospace 8(7):177(2021) 경유. 1차 전거(AGARD AG-323) 미도달
- Sharma et al., arXiv:2310.13548(ICLR 2024) — 상용 어시스턴트 5종 sycophancy 정량
- Laban et al., arXiv:2311.08596 — FlipFlop, 반박 시 정답 뒤집힘
- arXiv:2604.18005(ACL 2026 Findings) · arXiv:2604.24698(2026-04-27) — 다중에이전트 다양성 붕괴의 구조 원인, 페르소나 충실도와 고정관념 증폭. 둘 다 초신규 프리프린트
- Hegazy, arXiv:2410.12853(2024-10) — 이질 모델 조합의 토론 성적 개선
- Berg/Nelson/Rietz(2008), Int'l J. Forecasting — 아이오와 전자시장 장기 정확도
- Mellers et al.(2015), Judgment and Decision Making 10(3) — Good Judgment Project 브라이어 점수(aiimpacts.org 정리 경유)
- 앙상블 창발(온도·압력) — 통계역학 표준 교과